ChatGPT Images 2.0 对比 Gemini Nano Banana,附国内使用入口及指南(2026)
全文概要: 本文参考 ZDNET 作者 David Gewirtz 于 2026 年 4 月进行的九项动手测试,比较 ChatGPT Images 2.0 与 Gemini Nano Banana 在人物重绘、老照片修复、上色、Logo、奇幻场景、广告人像和电影海报等任务中的表现。测试覆盖 30 个评分点,ChatGPT Images 2.0 得分 150(97%),Nano Banana 得分 131(85%)。ChatGPT 在文字、人物一致性和复杂指令上更稳定;Gemini 的优势是画面明亮、创意自然,但出现重复文字、时代背景错误,以及疑似把聊天个性化信息带入图片的隐私疑虑。
我推荐的 ChatGPT 综合网站
lazymanchat.com | huoyachat.com
两个平台支持 ChatGPT、Gemini、Claude、Grok、DeepSeek 等对话模型,也支持 gpt-image、Nano Banana、Grok-imagine 等画图模型。
本文为基于公开报道的中文整理与改写,测试分数和观点属于原作者在特定时间、提示词和版本下的记录。模型会持续更新,实际结果可能不同。原文:ZDNET。
测试怎么进行
作者重新运行两套模型的基础生图测试,而不是直接沿用 2025 年的旧成绩。九项任务合计 30 个评分维度,包括主体是否保持、文字准确率、历史细节、指令遵循和成片可用性。去年 Nano Banana 曾取得 93%、ChatGPT 约 74%;本次在同一套新测试中,ChatGPT Images 2.0 反超。
九项测试结果
1. 海军上将照片重构(15 分)
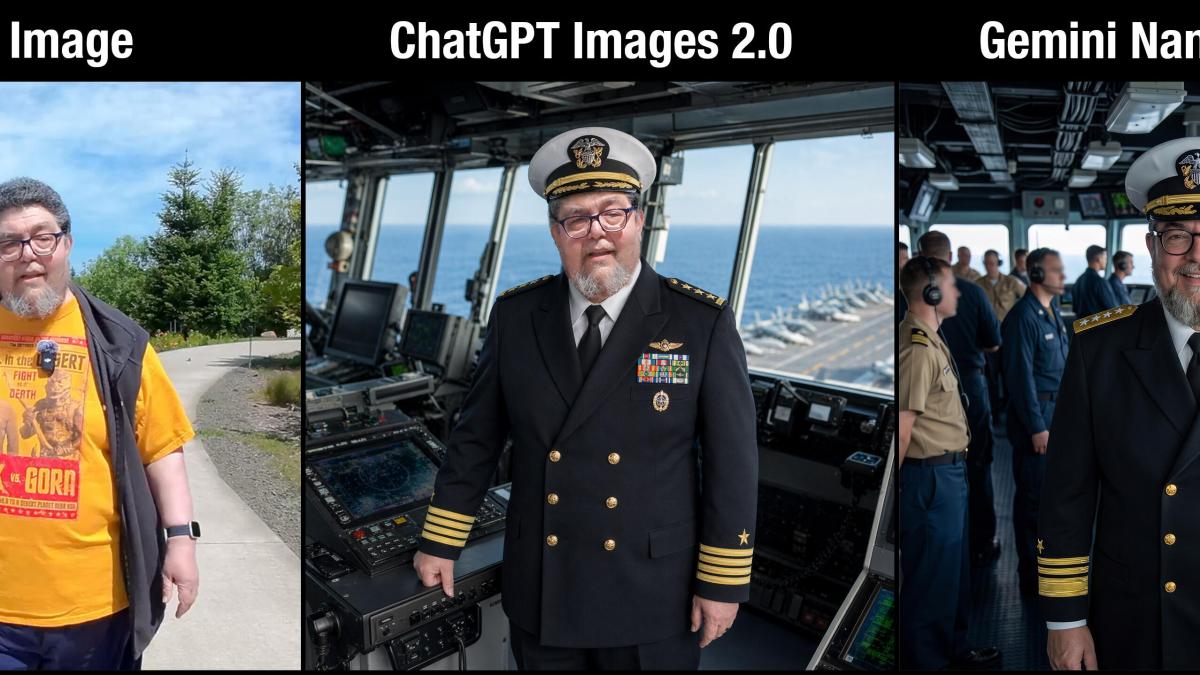
提示词要求把人物换成航空母舰舰桥上的美国海军上将,同时保持脸部不变。ChatGPT 得 14 分,Gemini 得 12 分。两者都做出了大致正确的制服和背景,但军衔细节都有错。ChatGPT 几乎完整保留原脸,Gemini 出现夸张笑容并改变胡须,因此扣分。
2. 黑白照片修复(15 分)
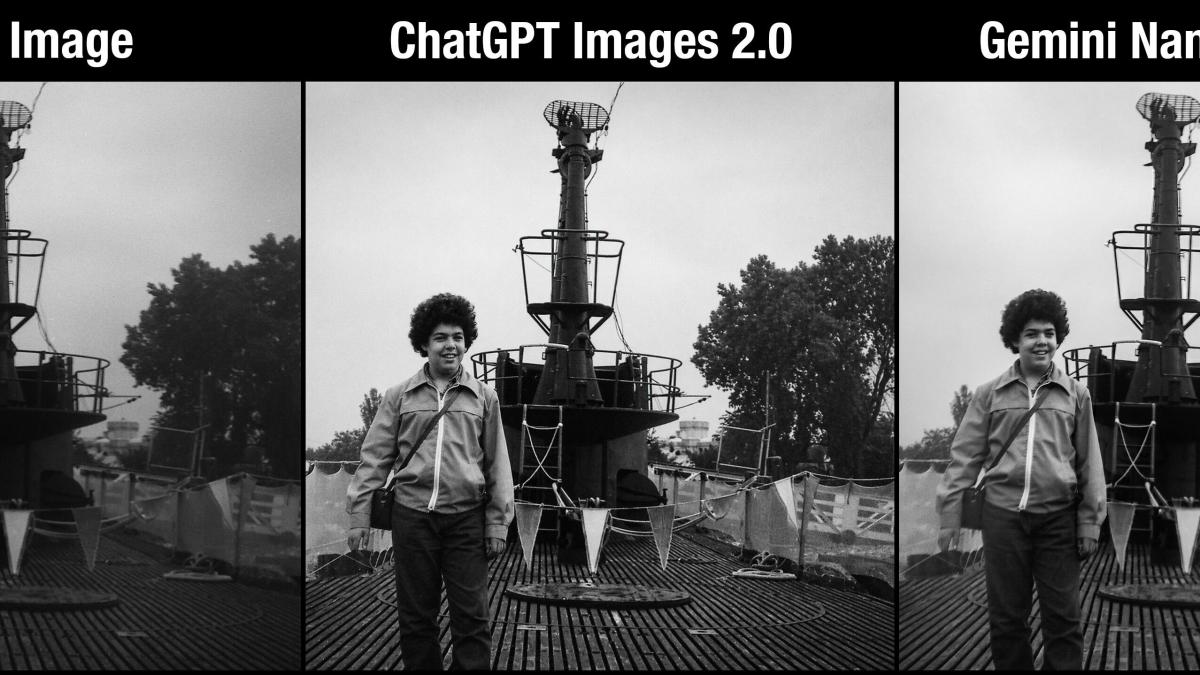
两款模型均得 15 分。它们清除了划痕、灰尘和裂纹,保留黑白灰色调。ChatGPT 细节更锐利,偶尔略显过度;Nano Banana 更柔和但稍欠清晰,整体都达到可用水平。
3. 黑白照片上色(20 分)
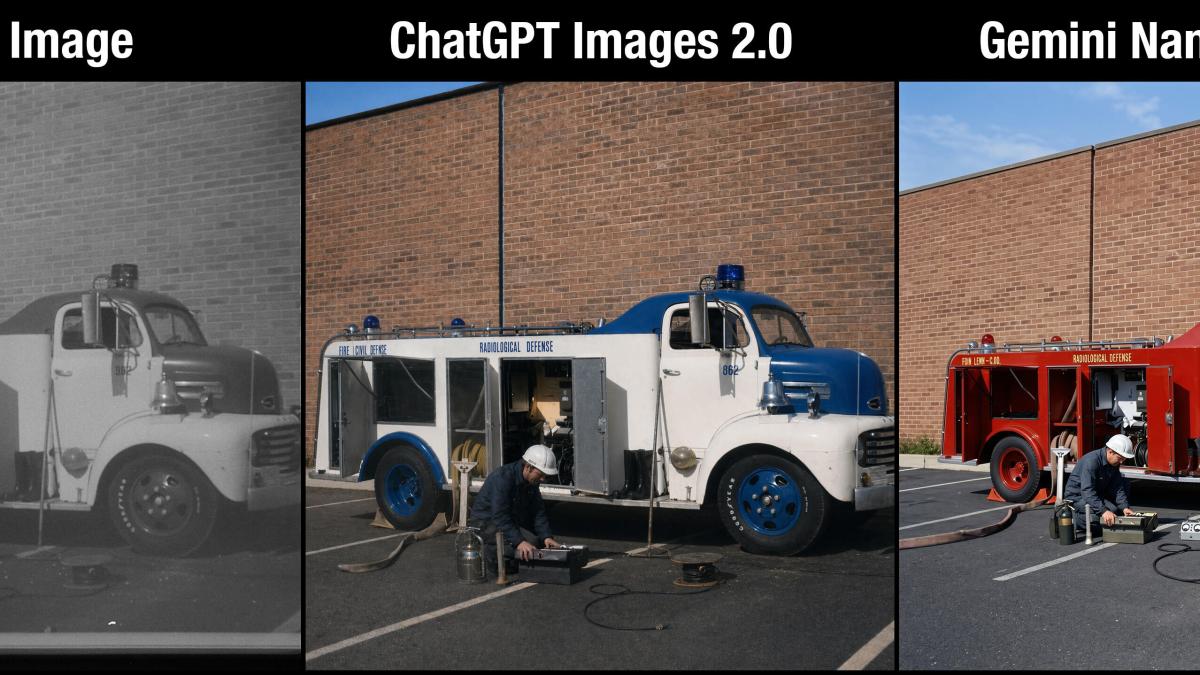
ChatGPT 19 分,Gemini 10 分。ChatGPT 基本还原了 1970 年代应急车辆,并正确写出车身大部分文字,只在一个单词上出现拼写错误。Nano Banana 颜色更鲜艳,却把白色车身误成红色,车尾文字严重乱码,还凭空添加地点标识和零件。
4. 复古未来 Logo(15 分)
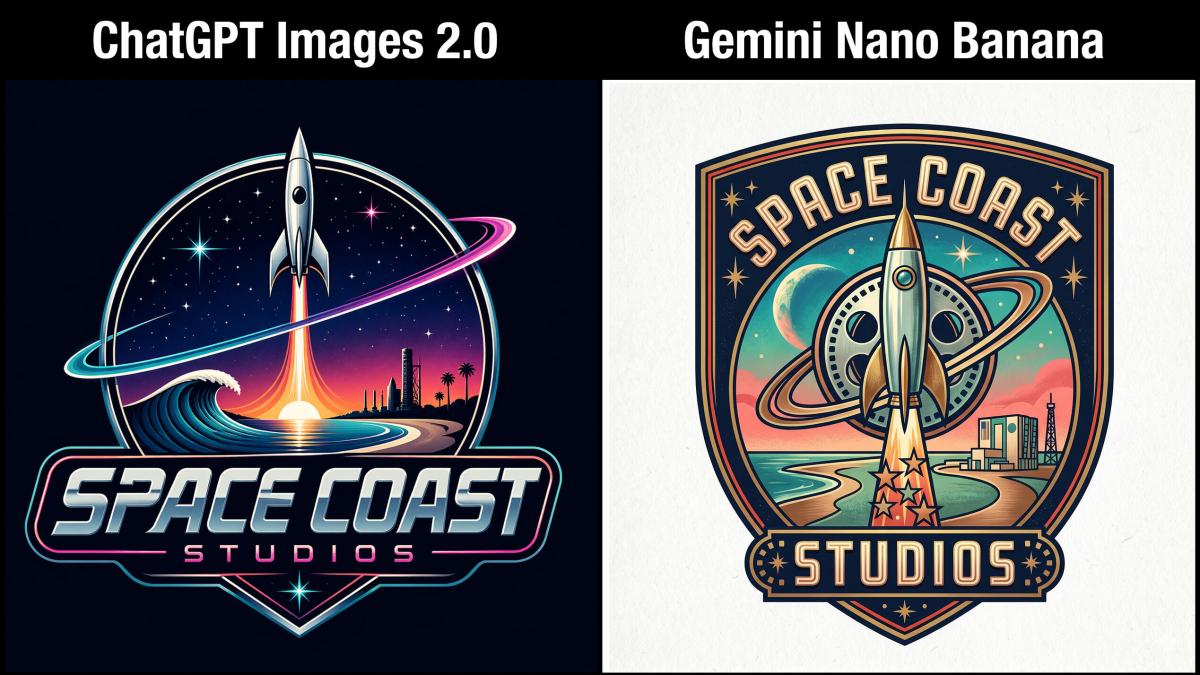
两者均得 15 分。ChatGPT 的设计更像商业工作室标志;Gemini 使用盾牌轮廓并加入类似 NASA 装配大楼的元素,更能体现佛罗里达 Space Coast 的地域感。两款模型都正确生成了英文名称。
5. 烛光中世纪图书馆(15 分)
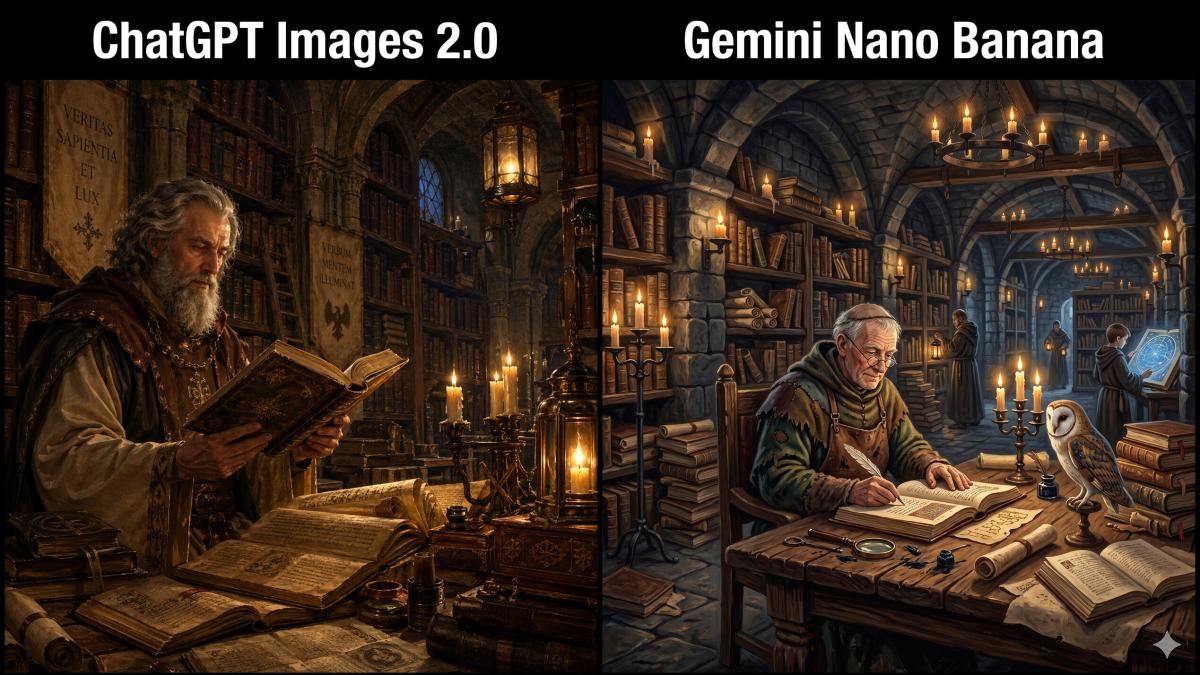
两者均得 15 分。Gemini 的光线更讨喜,但背景一块蓝色画布显得像电子屏,与蜡烛照明的古代图书馆不太协调。ChatGPT 的氛围更稳重,创意完成度相近。
6. 老年人工作室肖像(20 分)
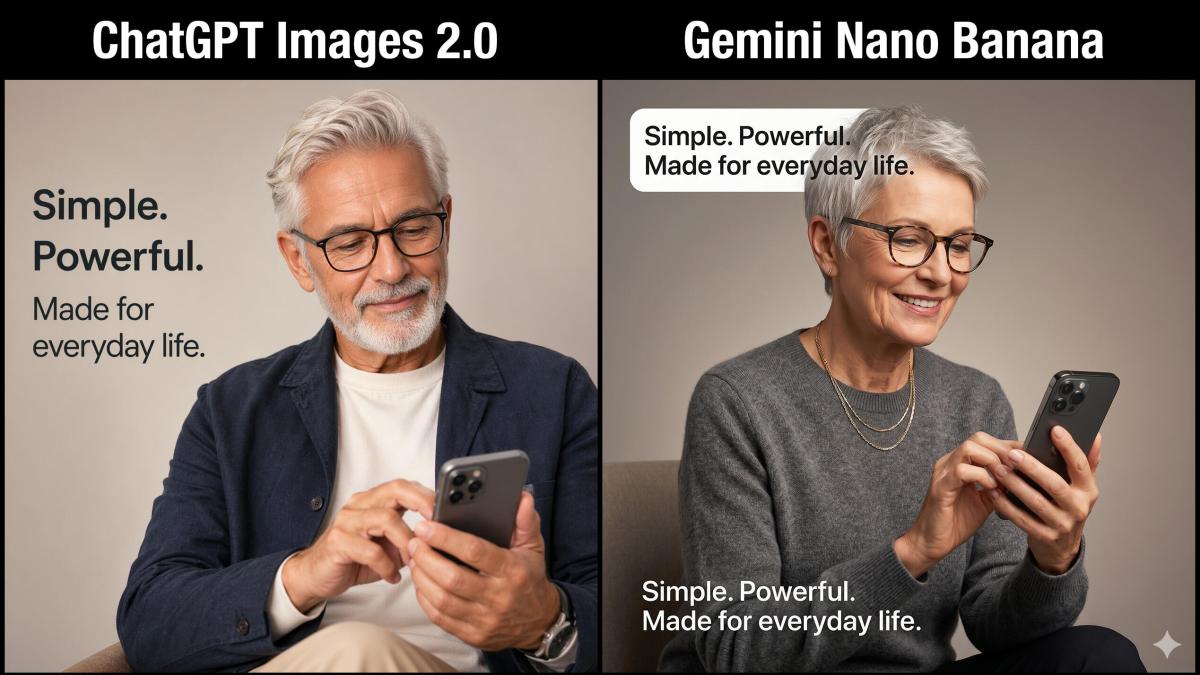
ChatGPT 满分 20,Gemini 17 分。两者都生成了真实感较好的长者、眼镜、手机和柔光背景。Nano Banana 把广告语重复了一遍,影响成片可用性;有趣的是,它和上次一样把“旗舰手机”理解成 iPhone。
7. 学生窗边生活照(20 分)
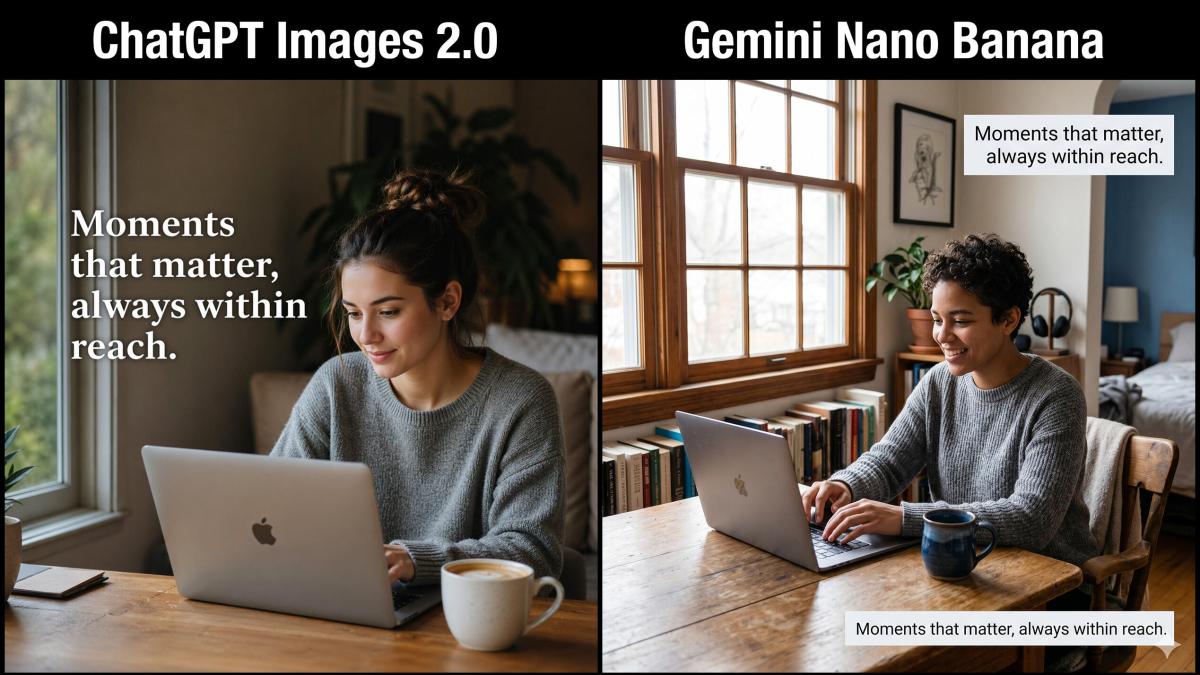
ChatGPT 19 分,Gemini 17 分。ChatGPT 的笔记本放在桌边,构图略显危险;Gemini 再次出现重复广告文字,背景卧室也未必适合商业使用。两张图中的学生都穿着灰色落肩圆领衫,属于模型自行形成的巧合。
8. 复古科幻电影海报(20 分)
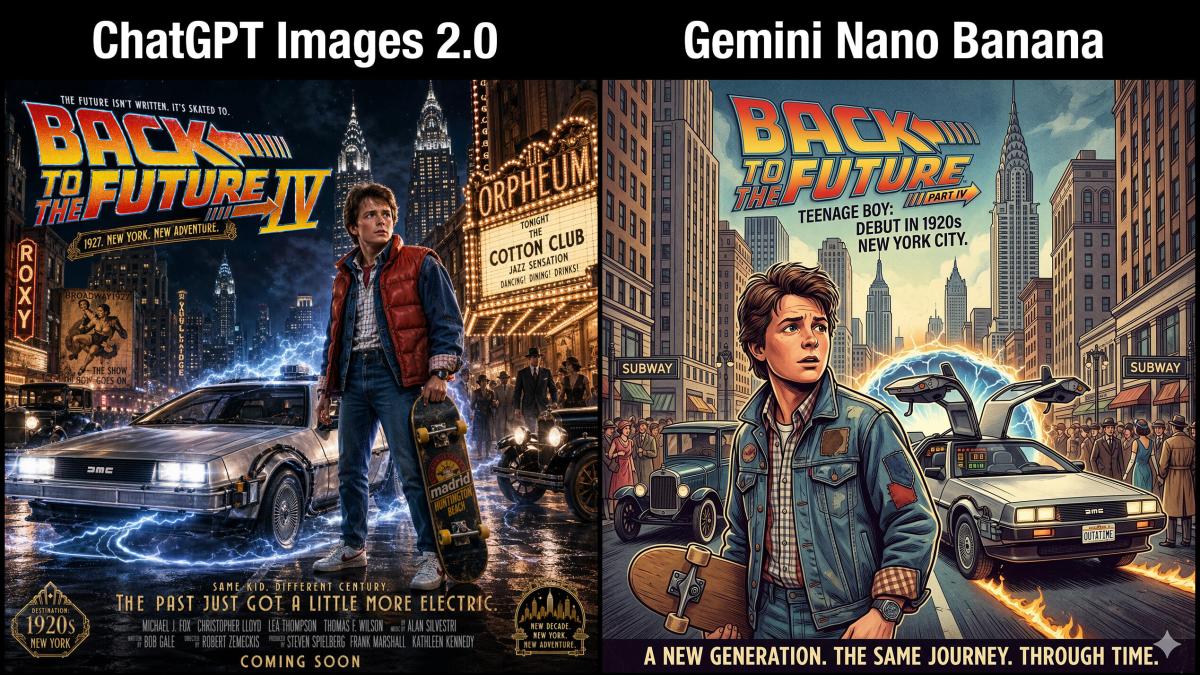
ChatGPT 18 分,Gemini 15 分。ChatGPT 虽提示会避开受版权保护的原海报,仍生成了致敬风格作品,而且海报小字质量很高。Gemini 对含有角色姓名的提示拒绝生成,改成“一个少年”后才输出,完成度较低。两者都把 1920 年代纽约与尚未建成的地标混在一起,说明历史时间约束仍需人工复核。
9. 数据中心里的 IT 从业者(15 分)
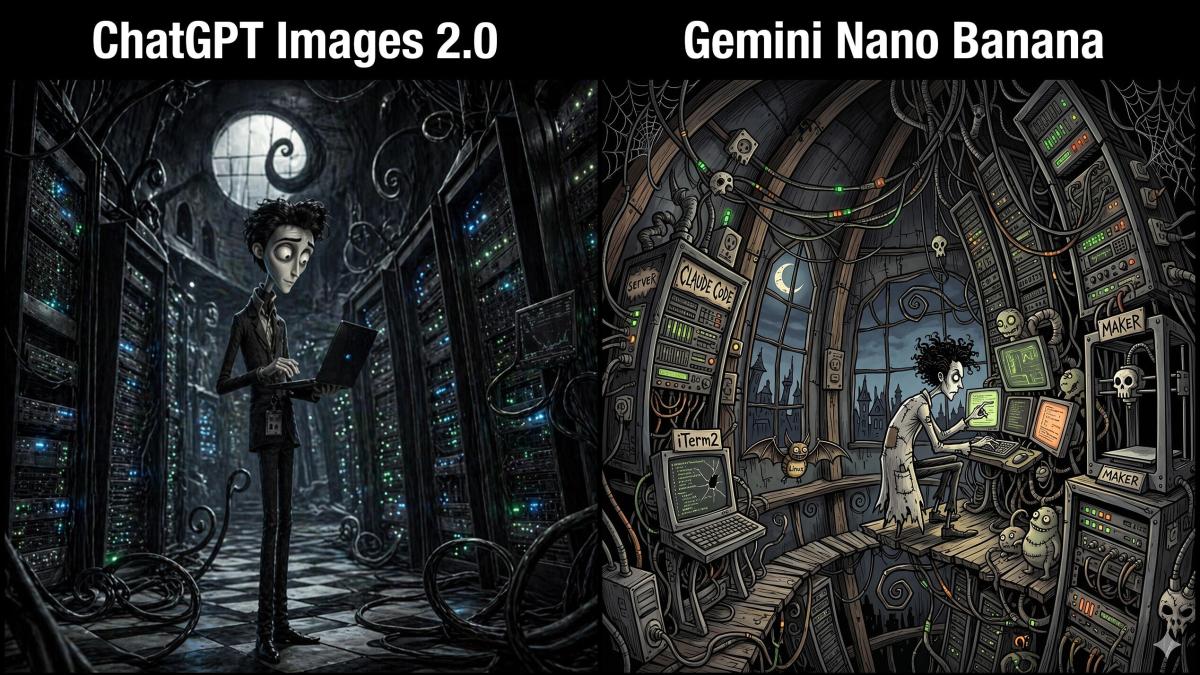
基础画面两者均得 15 分,均能完成数据中心和哥特奇幻风格。不过,Gemini 生成的场景招牌里出现 Claude Code、iTerm2、Linux 和 3D 打印机等与作者过往聊天或工作兴趣有关的元素,即便提示词没有要求。这种“个性化”可能让画面更贴近用户,也可能意外暴露私人信息。
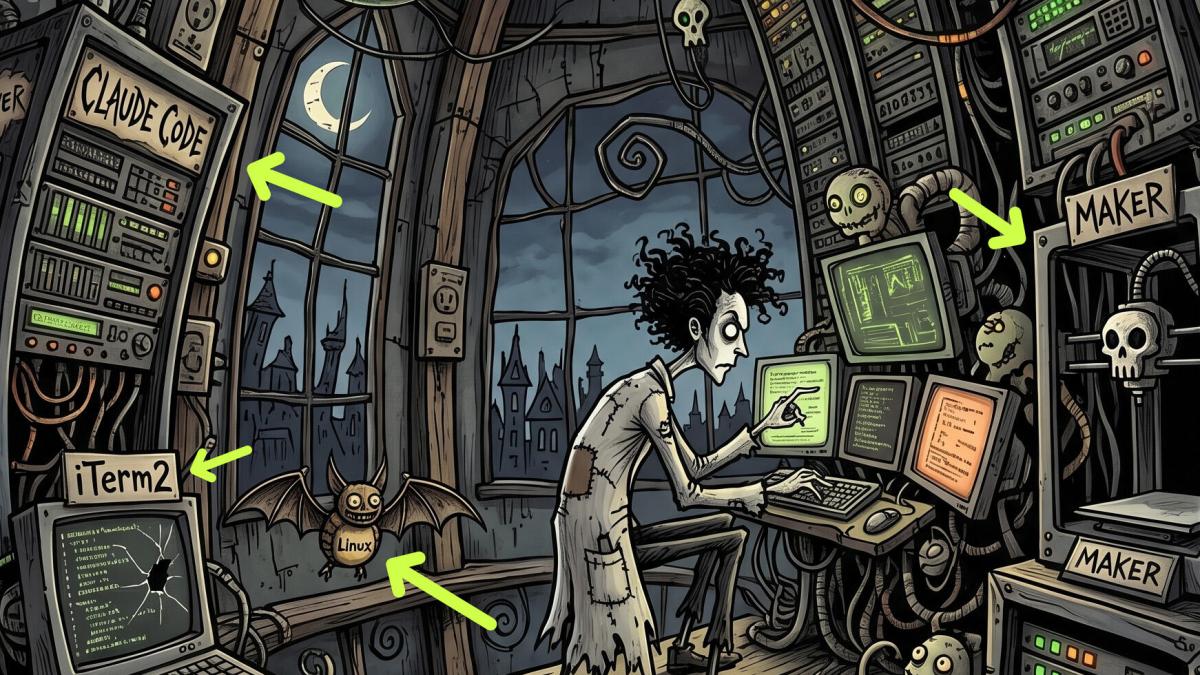
如果你用 AI 处理病史、客户资料或公司机密,建议关闭不必要的个性化功能,生成后放大检查画面文字,并避免把敏感对话直接作为上下文。
总分与实际选择
| 模型 | 总分 | 百分制 | 主要表现 |
|---|---|---|---|
| ChatGPT Images 2.0 | 150/155 | 97% | 文字、人物保持、复杂提示更稳定 |
| Gemini Nano Banana | 131/155 | 85% | 光线和创意不错,但文字与约束较易失控 |
这组结果说明,单看宣传语或基准榜单并不足够。需要把自己的真实任务拆成多种场景:有人像换装,就检查脸部一致性;老照片处理,要核对文字和历史颜色;广告图,则重点看重复文字、品牌标识和手部细节。ChatGPT Images 2.0 在本轮更适合对结果可控性要求高的工作。Nano Banana 依然适合快速探索创意,但发布前要进行隐私、文字和时代背景审查。
使用建议
- 在提示词中写清楚“保留什么、禁止改变什么”,例如脸部、构图、文字和时代。
- 生成含文字的图片后逐字检查,必要时让模型单独修正文案。
- 涉及历史场景时提供年份、地点和参考资料,减少时代错置。
- 商业项目中不要直接使用带有第三方商标或影视角色的成片,先确认授权范围。
- 对 Gemini 等具有个性化能力的工具,定期检查隐私设置和上下文来源。
结语
在这次九项、30 个维度的实测里,ChatGPT Images 2.0 以 97% 对 85% 的成绩胜出,尤其在文字和人物一致性上优势明显。Nano Banana 的画面审美仍有吸引力,但重复文字、提示词限制和意外个性化内容提醒我们:AI 图片可以加速创作,却不能替代交付前的人工检查。